


Des communications internes divulguées révèlent que Nvidia utilise quotidiennement des vidéos YouTube d'une durée de vie entière pour entraîner son modèle d'IA vidéo, et que Jensen est satisfait des progrès accomplis
Nvidia entraîne son Omniverse, ses voitures autonomes et ses voitures "humaines numériques" à partir de données extraites de "80 années de vidéos par jour" de YouTube et d'autres sources, a révélé une enquête de 404 Media.
Des fuites de communications internes obtenues par 404 Media indiquent que Nvidia utilise ces données pour entraîner son modèle de monde vidéo IA baptisé Cosmos (à ne pas confondre avec le service d'apprentissage profond Cosmos de l'entreprise )). Cosmos est conçu en interne comme un modèle qui alimenterait d'autres lignes de produits Nvidia, notamment GeForce, l'architecture GPU, DGX, les cadres d'apprentissage profond, Omniverse, Avatar, le projet GR00T et les véhicules autonomes.
Les dirigeants de Nvidia ont qualifié Cosmos de modèle de base de pointe"qui encapsule la simulation du transport de la lumière, la physique et l'intelligence en un seul endroit pour débloquer diverses applications en aval essentielles pour Nvidia"
404 Media a eu accès à des messages Slack d'employés internes qui ont révélé comment le personnel utilisait le programme en ligne de commande yt-dlp pour télécharger des vidéos YouTube en utilisant 20 à 30 machines virtuelles AWS qui rafraîchissent les adresses IP pour éviter d'être bloquées par YouTube. Le site de partage de vidéos était la principale source de récupération des vidéos, les employés ayant également envisagé d'autres sources telles que Netflix et Discovery Channel.
Les communications Slack montrent des employés discutant des ramifications juridiques de l'utilisation de contenus protégés par des droits d'auteur pour entraîner l'IA, mais les chefs de projet les ont rejetées en disant qu'il s'agissait d'une décision de l'exécutif, et qu'ils n'avaient pas à s'en inquiéter.
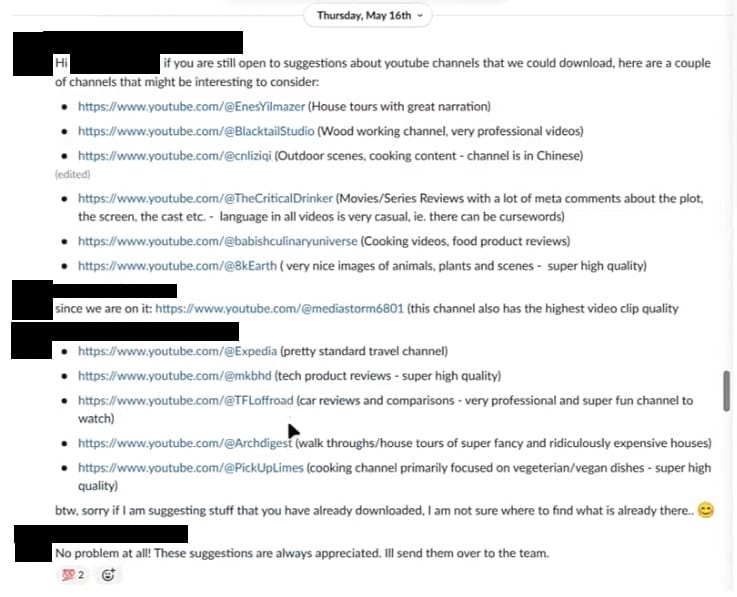
Parmi les chaînes YouTube populaires que les employés de Nvidia ont présélectionnées figurent MKBHD, PickUpLimes, Architectural Digest, Expedia, Mediastorm6801, 8kEarth et The CriticalDrinker, pour n'en citer que quelques-unes.
Contactés par 404 Media, YouTube et Netflix ont tous deux déclaré que l'utilisation de contenus sur leurs plateformes pour entraîner des modèles d'IA constituait une violation flagrante de leurs conditions d'utilisation.
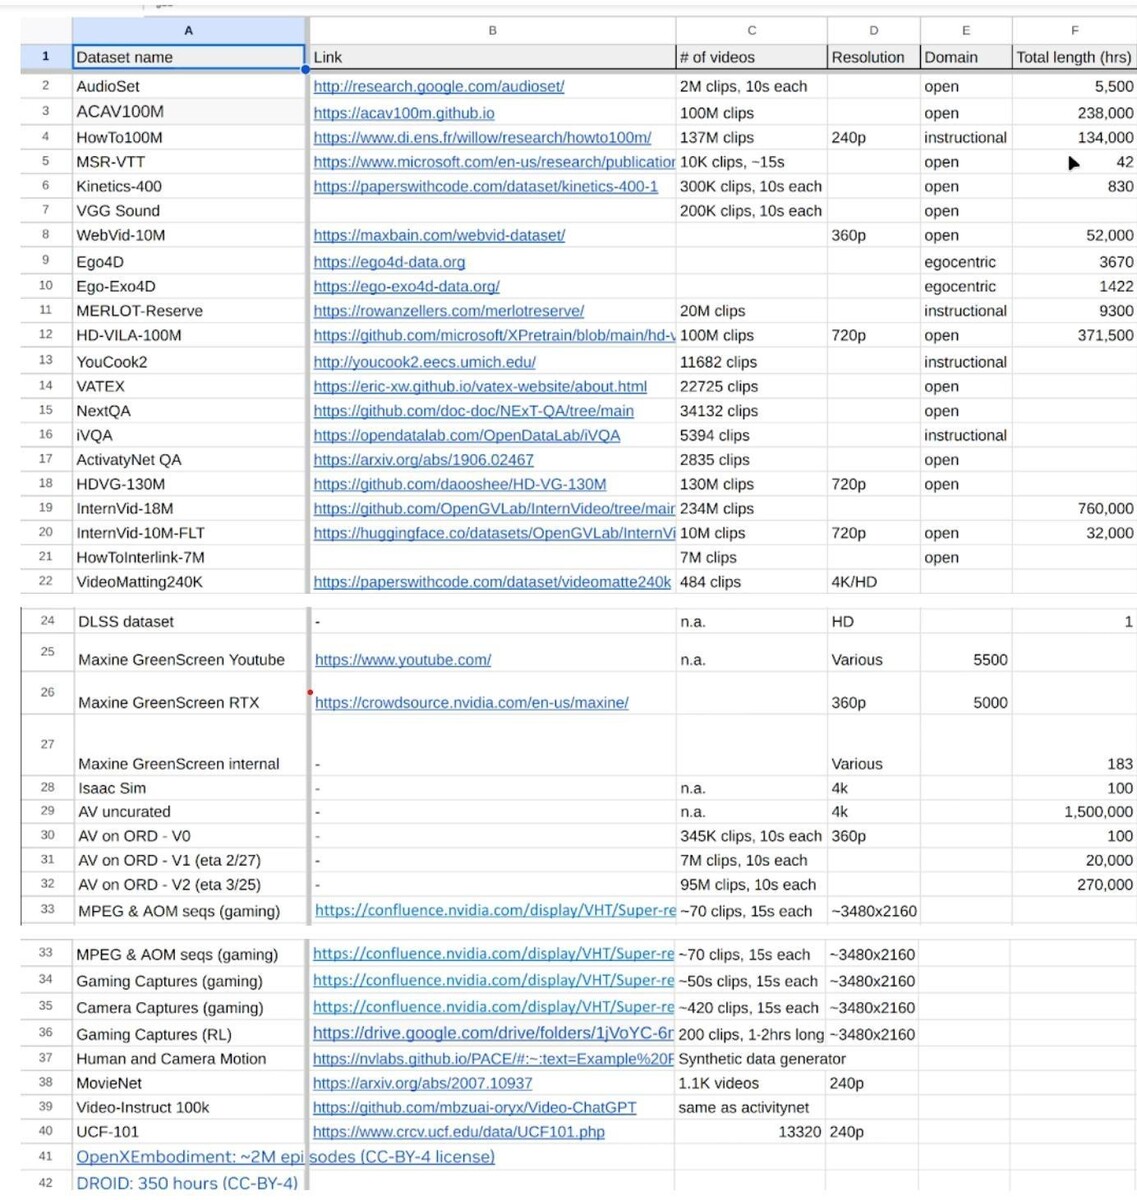
L'utilisation de données protégées par des droits d'auteur pour entraîner des modèles d'IA reste une zone grise sur le plan juridique. Des ensembles de données publiques tels que InternVid-10MHD-VG-130Met d'autres basés sur des millions de vidéos YouTube existent, mais ils ne sont destinés qu'à la recherche universitaire et non à des fins commerciales. Bien que Nvidia dispose de chercheurs universitaires, les résultats finiront par aboutir à un produit commercial.
Il y a eu quelques législations qui imposent des normes de transparence et obligent les entreprises qui travaillent sur des modèles d'IA fondamentaux à collaborer avec la FTC et le Bureau des droits d'auteur. Mais les entreprises ne divulguent pas nécessairement leurs ensembles de données sources, ce qui rend l'audit beaucoup plus difficile.
Alors que les grandes entreprises d'IA continuent de mettre la main sur toutes les données publiques disponibles pour former des modèles plus efficaces, des changements législatifs sont absolument nécessaires pour garantir la sécurité des consommateurs et protéger la propriété intellectuelle des créateurs.
L'année dernière, le New York Times a intenté un procès à OpenAI et à Microsoft pour utilisation non autorisée d'articles de la publication protégés par le droit d'auteur afin d'entraîner des modèles d'IA. En mai, les artistes visuels ont intenté un procès contre Stability AI, Midjourney, DeviantArt et Runway AI pour avoir utilisé sans autorisation des copies de leurs œuvres pour entraîner des modèles d'IA.
YouTube s'avère être une mine d'or de données pour les entreprises d'IA. Récemment, Wired a rapporté que des poids lourds tels que Apple, Nvidia, Anthropic et Salesforce ont récupéré les sous-titres de 173 536 vidéos YouTube provenant de plus de 48 000 chaînes pour entraîner leur IA.
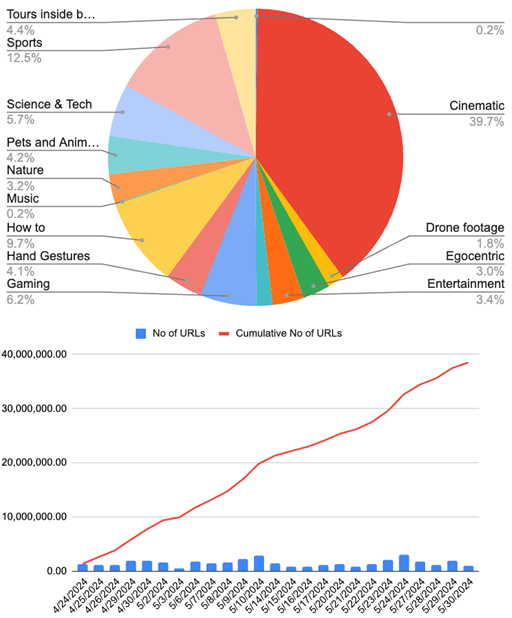
Jusqu'à la fin du mois de mai, le personnel de Nvidia a annoncé en interne qu'il avait compilé 38,5 millions d'URL de vidéos, la majorité d'entre elles étant des contenus cinématographiques. Les ingénieurs ont également ajouté des ensembles de données tels que Ego-Exo4DEgo4DHOI4Det des données de jeu provenant de GeForce Now.
Alors qu'Ego-Exo4D et Ego4D peuvent faire l'objet d'une licence pour un usage académique et commercial, HOI4D est distribué sous une licence CC BY-NC qui interdit spécifiquement l'utilisation commerciale.
L'équipe forme actuellement un modèle de 1B avec 16 nœuds chacun, et prévoit de l'étendre à 10B.
Nvidia a déclaré à 404 Media par courriel que"nos modèles et nos efforts de recherche sont en totale conformité avec la lettre et l'esprit de la loi sur les droits d'auteur"
Entre-temps, le PDG de Nvidia, Jensen Huang, semble satisfait des progrès réalisés par son équipe.
Il se serait exclamé : "Excellente mise à jour. De nombreuses entreprises doivent construire des FM vidéo [modèles de base]. Nous pouvons offrir un pipeline entièrement accéléré."
SCOOP from @samleecole: Leaked Slacks and documents show the incredible scale of NVidia's AI scraping: 80 years — "a human lifetime" of videos every day. Had approval from highest levels of company despite staff legal/ethical concerns:https://t.co/DydXOyffUQ
— Jason Koebler (@jason_koebler) August 5, 2024
Source(s)
404 Médias (nécessite une inscription)
 Add as a preferred source on Google


